| Produto | Resolução espacial | Variáveis disponíveis |
|---|---|---|
| Microdados da amostra | Área de ponderação | Todas os itens do Questionário da Amostra |
| Agregados por setor | Setor censitário | Somente itens do Questionário Básico |
| Grade Estatística | 200 x 200 m (urbano) / 1 x 1 km (rural) | Totais de população e domicílios (2) |
9 Grade Estatística
9.1 Introdução
Nos capítulos anteriores, exploramos os dois principais produtos tabulares do Censo Demográfico: os Agregados por Setor Censitário e os Microdados da Amostra. Juntos, eles cobrem um amplo espectro de possibilidades analíticas, mas cada um com seus próprios limites. Os Agregados chegam ao nível do setor censitário com milhares de variáveis. Os Microdados oferecem uma riqueza temática ainda maior, porém com resolução espacial restrita às áreas de ponderação. Neste capítulo, apresentaremos um terceiro produto do Censo que ocupa uma posição singular nesse espectro, a Grade Estatística.
A Grade Estatística é o produto do Censo de maior resolução espacial disponível ao público, com células de 200 x 200 metros nas áreas urbanas e 1 x 1 quilômetro nas áreas rurais. Essa granularidade espacial superior vem acompanhada, no entanto, de uma restrição temática significativa. A Grade disponibiliza apenas duas variáveis, a população total e o número de domicílios ocupados. A restrição existe por razões de sigilo estatístico, uma vez que células muito pequenas poderiam permitir a identificação de indivíduos. A Tabela 9.1 resume o posicionamento da Grade em relação aos produtos do Censo já vistos até então.
Apesar das poucas variáveis, a Grade possui um conjunto de características que a torna um produto analítico poderoso, especialmente para estudos de distribuição espacial da população e para comparações entre os Censos de 2010 e 2022.
A distribuição de dados censitários em uma malha regular de células retangulares teve início no Japão em 1969, quando o Escritório de Estatística do país publicou dados do Censo de Tóquio nesse formato. Nos anos seguintes, países nórdicos como a Finlândia adotaram abordagens semelhantes para seus próprios Censos, e o modelo se difundiu gradualmente por outros países da Europa e da Ásia.
No Brasil, a viabilização da Grade Estatística dependeu de um salto tecnológico significativo ocorrido no Censo 2010. Naquela edição, o IBGE introduziu a coleta eletrônica de dados com GPS e o Cadastro Nacional de Endereços para Fins Estatísticos (CNEFE), que geocodificou os endereços de todos os domicílios visitados. Essa infraestrutura de geocodificação permitiu, pela primeira vez, associar cada domicílio a uma posição geográfica precisa e, consequentemente, agregar a população a células de tamanho fixo. O produto foi publicado em 2016 com dados do Censo 2010 (IBGE, 2016) e atualizado em 2024 com dados do Censo 2022 (IBGE, 2025). As próximas seções detalham as características metodológicas que sustentam essas possibilidades analíticas e mostram como trabalhar com a Grade no R.
9.2 Aspectos metodológicos
As células da Grade são classificadas como urbanas ou rurais de acordo com a Malha de Setores Censitários. Células que intersectam setores urbanos recebem dimensões de 200 x 200 metros, enquanto as demais recebem 1 x 1 quilômetro. Todas as células são projetadas no sistema de referência SIRGAS 2000, utilizando a Projeção Cônica Equivalente de Albers com meridiano central em -54°, garantindo que áreas e densidades sejam comparáveis em todo o território nacional.
Além da resolução básica, a Grade é disponibilizada em seis níveis hierárquicos: 200m/1km, 5km, 10km, 50km, 100km e 500km. Os níveis superiores resultam da agregação dos inferiores, e cada célula possui um identificador único que é preservado ao longo da hierarquia e entre as edições do Censo. A articulação das células no nível de maior agregação espacial (500km) pode ser vista na Figura 9.1.
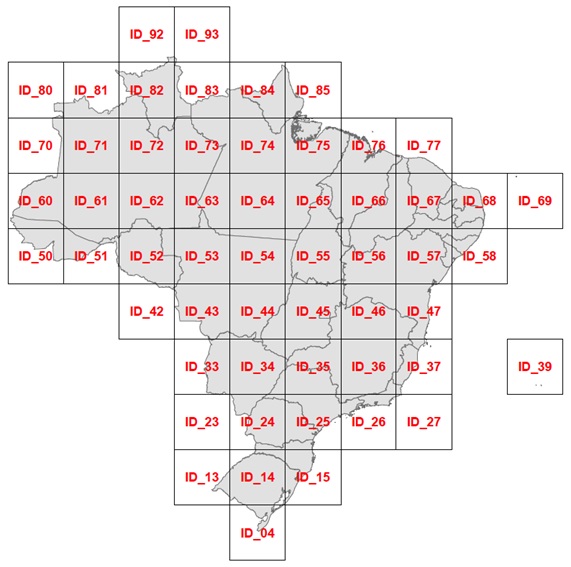
Esse nível de 500km é também a unidade de distribuição dos arquivos originais no FTP do IBGE, e cada quadrante recebe um identificador numérico próprio. O mapa interativo da Figura 9.2 permite explorar essa articulação sobre o território nacional. Navegando até Salvador (BA), por exemplo, percebe-se que a cidade é atravessada pela fronteira entre dois quadrantes, o ID 47, que cobre a porção Sul, e o ID 57, que cobre a porção Norte. Como veremos na Seção 9.4, o quadrante de cada célula acompanha os dados baixados no campo quadrante, de modo que essa informação hoje serve para compreender a articulação e localizar os arquivos originais, e não como uma etapa prévia ao download.
As estatísticas das células são derivadas dos microdados do universo do Censo Demográfico. Lembre-se que o universo compreende a totalidade dos domicílios visitados pelo recenseador, independentemente de terem respondido ao questionário básico ou ao da amostra. Esse ponto é relevante porque os microdados do universo não são disponibilizados ao público, uma vez que temos acesso apenas aos microdados da amostra, produto abordado no Capítulo 8. A vinculação entre os microdados do universo e as células da Grade é feita pelas coordenadas geográficas dos domicílios registradas no CNEFE.
Os campos estatísticos disponíveis nos arquivos da Grade diferem entre as duas edições, como mostra a Tabela 9.2. Os nomes dos campos da edição de 2022 constam no Quadro 4 das notas metodológicas do IBGE (IBGE, 2025). O documento metodológico de 2010 (IBGE, 2016) não apresenta um dicionário de dados equivalente, mas os nomes e descrição dos campos dessa edição podem ser consultados em fontes como o OSM Wiki (OpenStreetMap Wiki contributors, 2024). Note que a versão de 2010 disponibiliza totais de população por sexo (MASC e FEM), variáveis ausentes na edição de 2022.
A tabela traz uma terceira coluna com os nomes que o pacote geobr atribui a cada campo, já que é por meio desse pacote que baixaremos os dados na Seção 9.4. O geobr padroniza os nomes em letras minúsculas e harmoniza a população total em pop_total nas duas edições, o que elimina boa parte da atenção que antes era exigida ao comparar os dois Censos. Resta uma divergência relevante, a dos domicílios, que aparecem como dom_ocu em 2010 e total_dom em 2022. Esse é o ponto a vigiar ao realizar junções entre as bases, e voltaremos a ele na Seção 9.5. O pacote acrescenta ainda quatro campos de identificação territorial que não existem nos arquivos originais do IBGE.
geobr.
| Campo IBGE (2010) | Campo IBGE (2022) | Campo `geobr` | Descrição |
|---|---|---|---|
| ID_UNICO | ID_UNICO | id_unico | Identificador único da célula |
| POP | TOTAL | pop_total | Total de população |
| DOM_OCU | TOTAL_DOM | dom_ocu (2010) / total_dom (2022) | Total de domicílios ocupados (particular e coletivo) |
| MASC | — | pop_masc | Total de pessoas do sexo masculino |
| FEM | — | pop_fem | Total de pessoas do sexo feminino |
| nome_1km ... nome_500km | nome_1km ... nome_500KM | nome_1km ... nome_500km | Código da célula em cada nível hierárquico |
| QUADRANTE | QUADRANTE | quadrante | Quadrante de articulação (500 x 500 km) |
| — | — | code_muni | Código do município ao qual a célula foi atribuída |
| — | — | name_muni | Nome do município |
| — | — | code_state | Código da unidade da federação |
| — | — | abbrev_state | Sigla da unidade da federação |
É relevante mencionar que o número de células na resolução 200m/1km também muda entre os Censos. O Censo 2010 gerou 13,3 milhões de células na resolução básica, sendo 4.610.350 de 200m (34,7%) e 8.676.139 de 1km (65,3%). Em 2022, esse número cresceu para 14,1 milhões, um acréscimo de cerca de 841 mil células, com 5.486.725 células de 200m (38,84%) e 8.641.084 células de 1km (61,16%). Isso ocorre porque, ao se tornarem urbanizadas1, algumas áreas que estavam em células de 1km são subdivididas em células de 200m. Cabe destacar que células de 200m que porventura tenham se tornado rurais não passam por um processo de agregação2 para a resolução de 1km em um Censo posterior.
Uma diferença metodológica importante separa as duas edições. No Censo 2010, a geocodificação dos endereços ainda era incompleta, de modo que parte dos domicílios precisou ser alocada às células por meio de uma metodologia híbrida que combinava agregação direta com desagregação proporcional por área. Esse processo introduziu alguma imprecisão na distribuição espacial da população e gerou uma perda de dados de até 5% em algumas áreas. No Censo 2022, a geocodificação foi realizada em seis níveis de qualidade posicional. Os níveis 5 e 63, de maior incerteza, foram excluídos da Grade, mas eles representavam apenas 0,028% da população total, tornando a perda de dados praticamente nula (IBGE, 2025). Detalhes técnicos sobre a precisão das coordenadas do CNEFE serão melhor explicitados no próximo capítulo.
A Tabela 9.3 sintetiza as principais diferenças metodológicas entre os Censos de 2010 e 2022.
| Aspecto | Censo 2010 | Censo 2022 |
|---|---|---|
| Método de alocação | Híbrido (agregação + desagregação proporcional por área) | Agregação direta de endereços geocodificados |
| Geocodificação | Incompleta, complementada por alocação por área | Baseada nos 4 maiores níveis de qualidade; níveis inferiores (5 e 6) excluídos |
| Perda de dados | Até 5% em algumas regiões | 0,028% da população |
| Total de células (resolução básica) | 13,3 milhões | 14,1 milhões |
Com esse panorama metodológico em vista, a próxima seção examina as principais vantagens e limitações da Grade para fins analíticos.
9.3 Vantagens e limitações
A Grade apresenta quatro vantagens analíticas que a distinguem dos demais produtos do Censo (IBGE, 2016). A primeira é a estabilidade espaço-temporal. Como o identificador único de cada célula é idêntico nas edições de 2010 e 2022, isso contrasta diretamente com os setores censitários e áreas de ponderação, cujas fronteiras e identificadores são redesenhados a cada Censo para acompanhar o crescimento urbano e as necessidades operacionais da coleta. Salvador, por exemplo, tinha 3.592 setores censitários em 2010 e 4.555 em 2022. Uma comparação direta setor a setor entre as duas edições seria inviável, pois a maioria dos setores de 2010 não tem correspondente exato em 2022. Com a Grade, a comparação é feita simplesmente por meio de uma junção de ambas as tabelas pelo identificador único, como veremos na Seção 9.5.
A segunda vantagem é a adaptação a recortes espaciais personalizados. As células da Grade funcionam como blocos de construção que podem ser agregados, de forma aproximada, a qualquer geometria de interesse, como zonas de tráfego de pesquisas de mobilidade, distritos sanitários ou bacias hidrográficas. Ao somar as células que intersectam um recorte de interesse, obtém-se uma estimativa de população para esse recorte sem necessidade de microdados ou de técnicas de interpolação.
A terceira é a hierarquia e flexibilidade. Os seis níveis de resolução de quadrículas disponíveis no mesmo sistema de referência permitem navegar entre escalas de análise com facilidade. Uma análise que começa na escala metropolitana (nível 50km) pode ser aprofundada progressivamente até a resolução máxima sem mudar de sistema de coordenadas ou de conjunto de dados.
A quarta vantagem é a versatilidade de representação. A estrutura retangular regular da Grade permite tratar os dados tanto como vetor quanto como raster. Essa dualidade amplia o conjunto de ferramentas analíticas disponíveis, abrindo a possibilidade de aplicar métodos de processamento de imagem e análise espacial matricial.
Todavia, há restrições importantes com relação ao uso da Grade. A principal delas é o reduzido número de variáveis disponíveis. Com apenas população total e domicílios ocupados, ela não permite análises de renda, escolaridade, raça, acesso a serviços ou qualquer outro atributo socioeconômico. Para essas análises, os Microdados e os Agregados continuam sendo indispensáveis.
Uma segunda limitação diz respeito à geometria retangular das células. Como discutido no Capítulo 7 ao apresentar as grades hexagonais H3, células quadradas possuem dois tipos de vizinhança, os que compartilham aresta e os que compartilham apenas um vértice, com distância entre centros cerca de 41% maior neste último caso. Essa assimetria implica que análises de proximidade e acessibilidade, nas quais a equidistância entre vizinhos é uma propriedade desejável, produzem resultados geometricamente menos precisos em grades retangulares do que em grades hexagonais. Acrescenta-se ainda que anéis concêntricos de hexágonos aproximam círculos com mais fidelidade do que anéis quadrados, tornando a delimitação de zonas de influência e buffer mais natural naquele formato.
Por fim, a forma de distribuição dos dados pelo IBGE cria uma etapa adicional de trabalho antes do download. A Grade Estatística na sua melhor resolução (200m/1km) não é disponibilizada como um arquivo único para o país ou por município, mas em recortes por quadrantes de 500 x 500 km. Antes de baixar os dados, é preciso identificar quais quadrantes cobrem o município de interesse. Felizmente, essa restrição foi contornada mais recentemente com melhorias implementadas no pacote geobr do IPEA, que permite obter esses dados por município ou UF.
Com essas vantagens e limitações em mente, a próxima seção mostra como obter a Grade no R e transformá-la em mapas.
9.4 Obtendo e mapeando os dados no R
9.4.1 Obtenção da grade por município
O pacote geobr, a partir da sua versão 2.0.0, passou a disponibilizar a grade estatística recortada por município de interesse na função read_statistical_grid(). São necessários apenas dois argumentos, o ano da edição do Censo em year e o código de 7 dígitos do IBGE em code_muni. O código a seguir obtém as duas edições da Grade para Salvador (BA), cujo código municipal é 2927408.
library(tidyverse)
library(sf)
library(geobr)

ge_ssa2010 <- read_statistical_grid(year = 2010, code_muni = 2927408)
ge_ssa2022 <- read_statistical_grid(year = 2022, code_muni = 2927408)
Duas linhas de código substituem todo o trabalho de identificar quadrantes, baixar arquivos compactados, empilhá-los e recortá-los aos limites municipais. A função também mantém, por padrão, um cache local dos arquivos baixados (cache = TRUE), de modo que uma segunda chamada dentro da mesma sessão do R não repete o download.
DicaOutros recortes espaciais
O argumento code_muni aceita mais do que o código de um município. Passando a sigla ou o código de dois dígitos de uma unidade da federação, a função baixa a Grade de todo o estado, como em read_statistical_grid(year = 2022, code_muni = "BA") ou code_muni = 29. Com code_muni = "all", obtém-se a Grade do país inteiro. Para consultar códigos municipais sem sair do R, use geobr::lookup_muni().
NotaGrades muito grandes e os arquivos originais
A Grade de um município cabe confortavelmente na memória, mas o mesmo não vale para um estado populoso ou para o país, que reúne mais de 14 milhões de células. Para esses casos, o argumento output aceita os valores "duckdb" e "arrow", que devolvem uma tabela espacial preguiçosa em vez de um objeto sf carregado na memória. Assim, é possível filtrar e agregar os dados antes de trazê-los para a sessão do R.
Os arquivos originais do IBGE, organizados por quadrante de 500 x 500 km e em formato shapefile, continuam disponíveis no servidor FTP do instituto, em https://geoftp.ibge.gov.br/recortes_para_fins_estatisticos/grade_estatistica/.
9.4.2 Mapeando os resultados
Vamos primeiramente observar o formato destes arquivos de grade, relativo aos Censos de 2010 (Figura 9.3) e de 2022 (Figura 9.4), em que cada polígono corresponde a uma célula de 200m ou 1km, utilizando o ggplot2. Note como, em 2022, as poucas quadrículas do tipo rural de 2010 foram subdivididas em quadrículas do tipo urbano, de 200m4.
ge_ssa2010 |>
  ggplot() +
  geom_sf() +
  theme_minimal()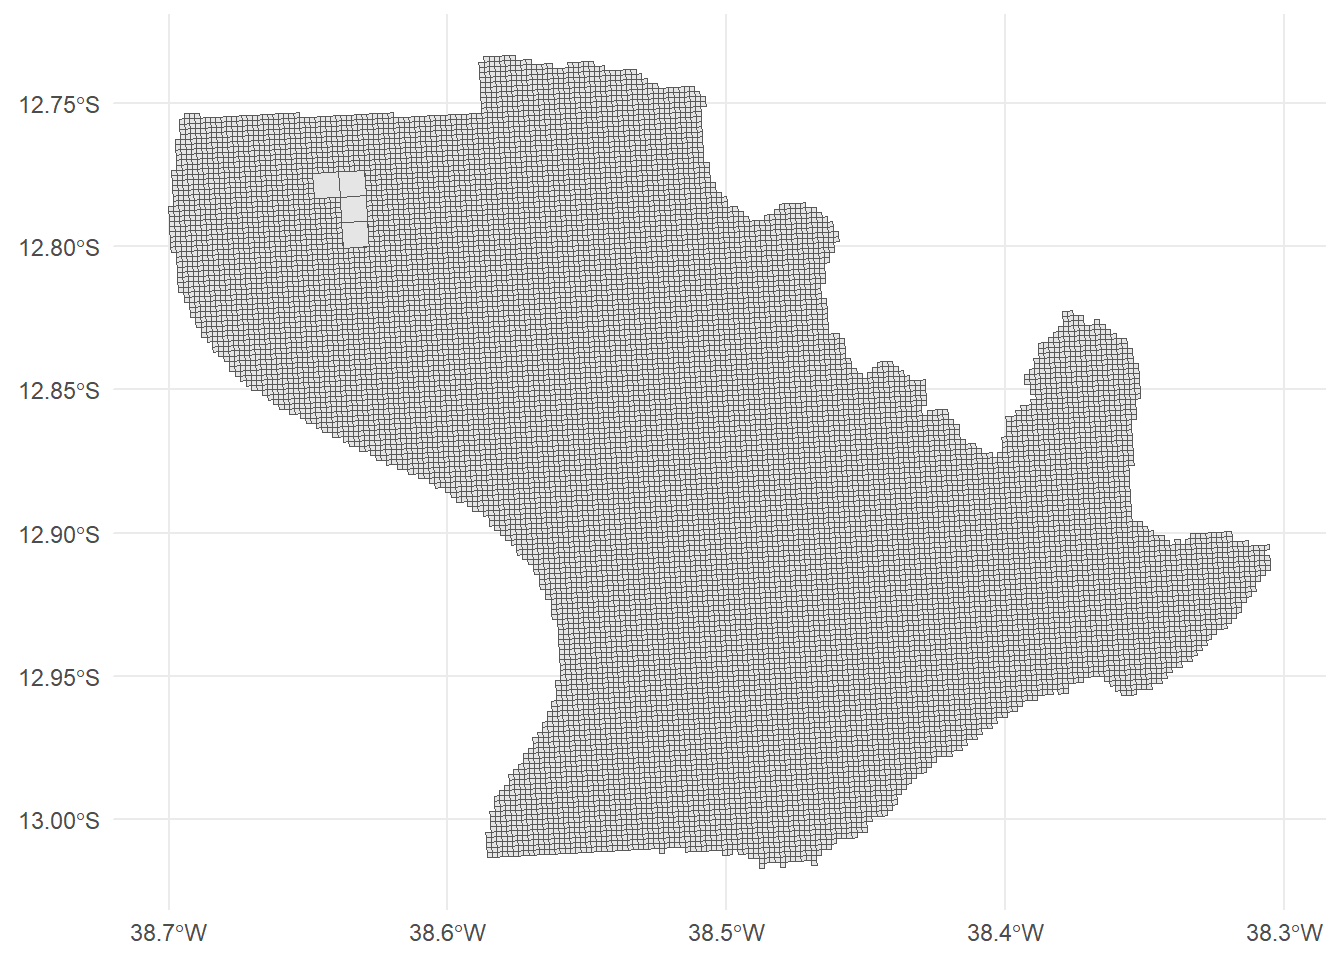
ge_ssa2022 |>
  ggplot() +
  geom_sf() +
  theme_minimal()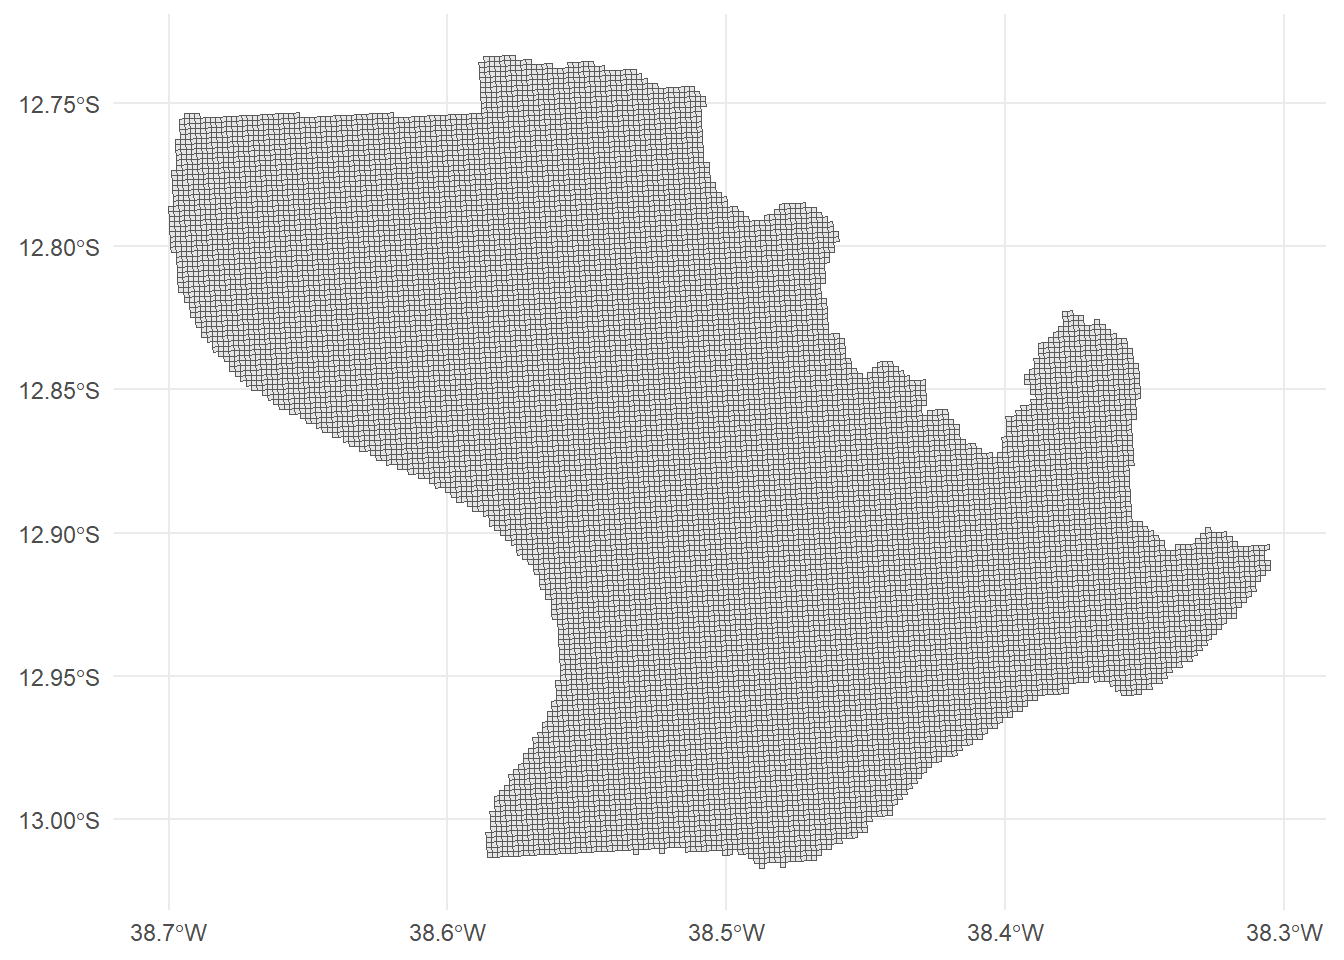
É igualmente interessante explorar as tabelas de dados que esses arquivos geográficos carregam consigo. Como cada objeto traz mais de uma dezena de colunas, vamos selecionar apenas os campos que nos interessam antes de visualizar os primeiros registros.
ge_ssa2010 |>
  st_drop_geometry() |>
  select(id_unico, pop_total, dom_ocu, quadrante) |>
  head()
# A tibble: 6 × 4
id_unico pop_total dom_ocu quadrante
<chr> <int> <int> <chr>
1 200ME66358N98634 0 0 ID_57
2 200ME66358N98636 0 0 ID_57
3 200ME66356N98638 0 0 ID_57
4 200ME66358N98638 0 0 ID_57
5 200ME66356N98640 0 0 ID_57
6 200ME66358N98640 0 0 ID_57 ge_ssa2022 |>
st_drop_geometry() |>
select(id_unico, pop_total, total_dom, quadrante) |>
head()# A tibble: 6 × 4
id_unico pop_total total_dom quadrante
<chr> <dbl> <dbl> <chr>
1 200ME66358N98634 0 0 ID_57
2 200ME66358N98636 0 0 ID_57
3 200ME66356N98638 0 0 ID_57
4 200ME66358N98638 0 0 ID_57
5 200ME66356N98640 0 0 ID_57
6 200ME66358N98640 0 0 ID_57 Duas coisas chamam a atenção nessas tabelas. A primeira é que o campo id_unico de cada célula permite identificar sua resolução. Aqueles que começam com "200M" correspondem a células de 200m (áreas urbanas), enquanto os que começam com "1KM" correspondem a células de 1km (áreas rurais). A segunda é o campo quadrante, que registra o quadrante de 500 x 500 km ao qual a célula pertence. Listando seus valores distintos, confirmamos o que o mapa da Figura 9.2 mostrava, já que Salvador se distribui entre dois quadrantes.
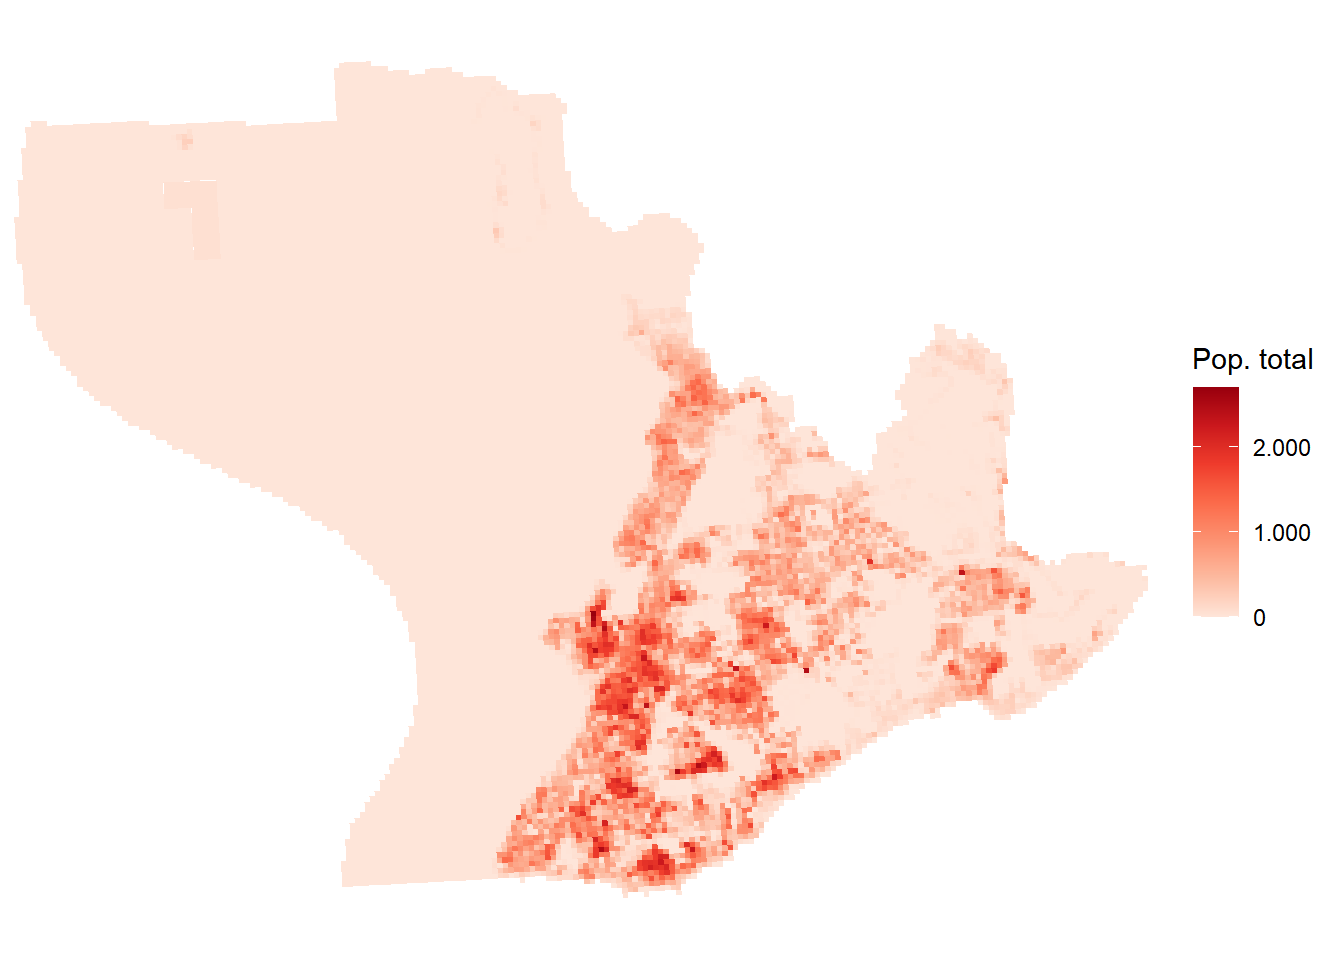
unique(ge_ssa2022$quadrante)[1] "ID_57" "ID_47"Entendida essa estrutura, podemos produzir alguns mapas coropléticos. Para o mapa de 2010 (Figura 9.5), observe que passamos a variável pop_total no mapeamento estético da cor de preenchimento dos polígonos (fill) e editamos essa coloração para a paleta “Reds” em scale_fill_distiller(). Neste caso, quanto mais intenso na cor vermelha, maior a população naquela quadrícula. O mapa de 2022 (Figura 9.6) usa exatamente o mesmo código, trocando apenas o objeto de entrada. Essa repetição é possível porque o geobr padroniza o nome da população total como pop_total nas duas edições, poupando o trabalho de lidar com os nomes originais POP e TOTAL dos arquivos do IBGE.
ggplot(ge_ssa2010) +
  geom_sf(aes(fill = pop_total), color = NA) +
  scale_fill_distiller(
    palette = "Reds",
    direction = 1,
    name = "Pop. total",
    na.value = "gray90",
    labels = scales::label_number(big.mark = ".", decimal.mark = ",")
  ) +
  coord_sf(expand = FALSE) +
  theme_minimal() +
  theme(
    axis.text  = element_blank(),
    axis.ticks = element_blank(),
    panel.grid = element_blank()
  )
ggplot(ge_ssa2022) +
  geom_sf(aes(fill = pop_total), color = NA) +
  scale_fill_distiller(
    palette = "Reds",
    direction = 1,
    name = "Pop. total",
    na.value = "gray90",
    labels = scales::label_number(big.mark = ".", decimal.mark = ",")
  ) +
  coord_sf(expand = FALSE) +
  theme_minimal() +
  theme(
    axis.text  = element_blank(),
    axis.ticks = element_blank(),
    panel.grid = element_blank()
  )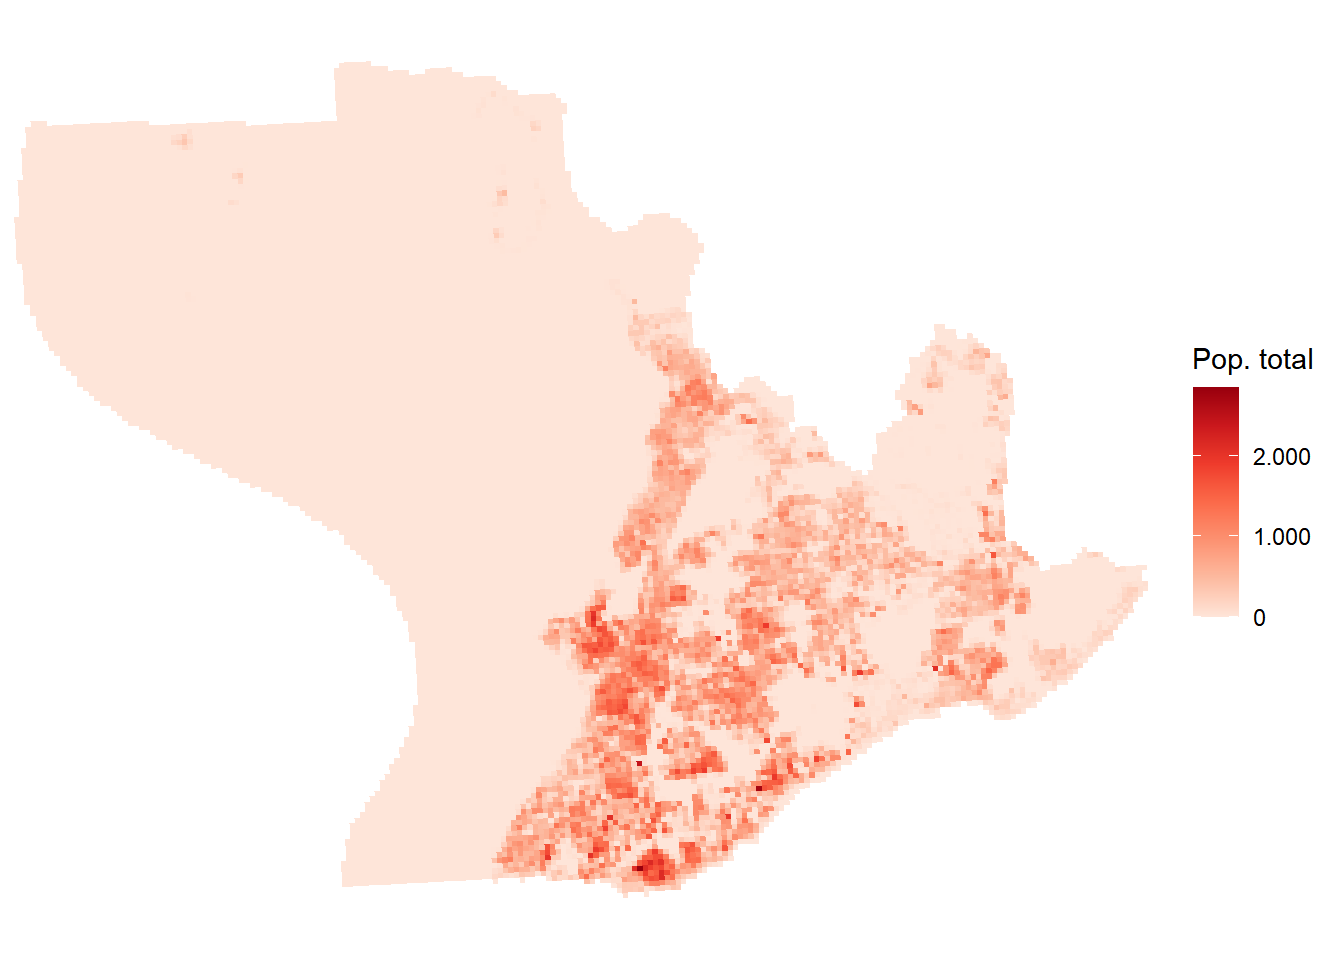
Os dois mapas de população revelam a distribuição espacial de Salvador com uma granularidade muito superior à dos setores censitários. Porém, a comparação visual entre eles para verificar onde houve crescimento ou retração entre as duas edições é mais difícil. A próxima seção explora esse potencial comparativo de forma sistemática, usando Maceió como caso de análise. Essa escolha revela o poder da Grade Estatística de mapear fenômenos importantes como deslocamentos populacionais significativos causados por desastres ambientais.
9.5 Variação populacional entre Censos: o caso de Maceió
A estabilidade do identificador id_unico entre as edições do Censo é a vantagem mais distintiva da Grade Estatística. Ela permite comparar diretamente a população e os domicílios de cada célula entre 2010 e 2022, identificando onde houve crescimento, estagnação ou declínio com uma resolução espacial de 200 metros. Para ilustrar essa capacidade, analisaremos o caso de Maceió (AL), onde esse tipo de comparação revela um fenômeno de grande impacto social e urbano.
Entre os dois Censos, a capital alagoana viveu os afundamentos do solo causados pela mineração de sal-gema, especialmente nos bairros de Pinheiro, Mutange, Bebedouro e Bom Parto. A subsidência progressiva do terreno, decorrente da dissolução das cavernas subterrâneas de onde o sal era extraído, tornou inabitáveis vastas áreas residenciais nesses bairros. A partir de 2018, o processo de evacuação compulsória de moradores se intensificou, resultando no deslocamento de dezenas de milhares de pessoas até o período do Censo 2022. O impacto desse fenômeno na distribuição espacial da população é precisamente o tipo de mudança que a comparação entre grades censitárias é capaz de revelar.
O procedimento de obtenção dos dados é o mesmo que usamos para Salvador, bastando trocar o código municipal para 2704302. Diferentemente de Salvador, Maceió está integralmente contida em um único quadrante, o ID 58, o que pode ser conferido inspecionando o campo quadrante depois do download.
library(tidyverse)
library(sf)
library(geobr)

ge_mcz2010 <- read_statistical_grid(year = 2010, code_muni = 2704302)
ge_mcz2022 <- read_statistical_grid(year = 2022, code_muni = 2704302)

unique(ge_mcz2022$quadrante)
[1] "ID_58"Com os dados, é possível observar a grade de Maceió em ambos os anos em Figura 9.7 e Figura 9.8:
ge_mcz2010 |>
  ggplot() +
  geom_sf() +
  theme_minimal()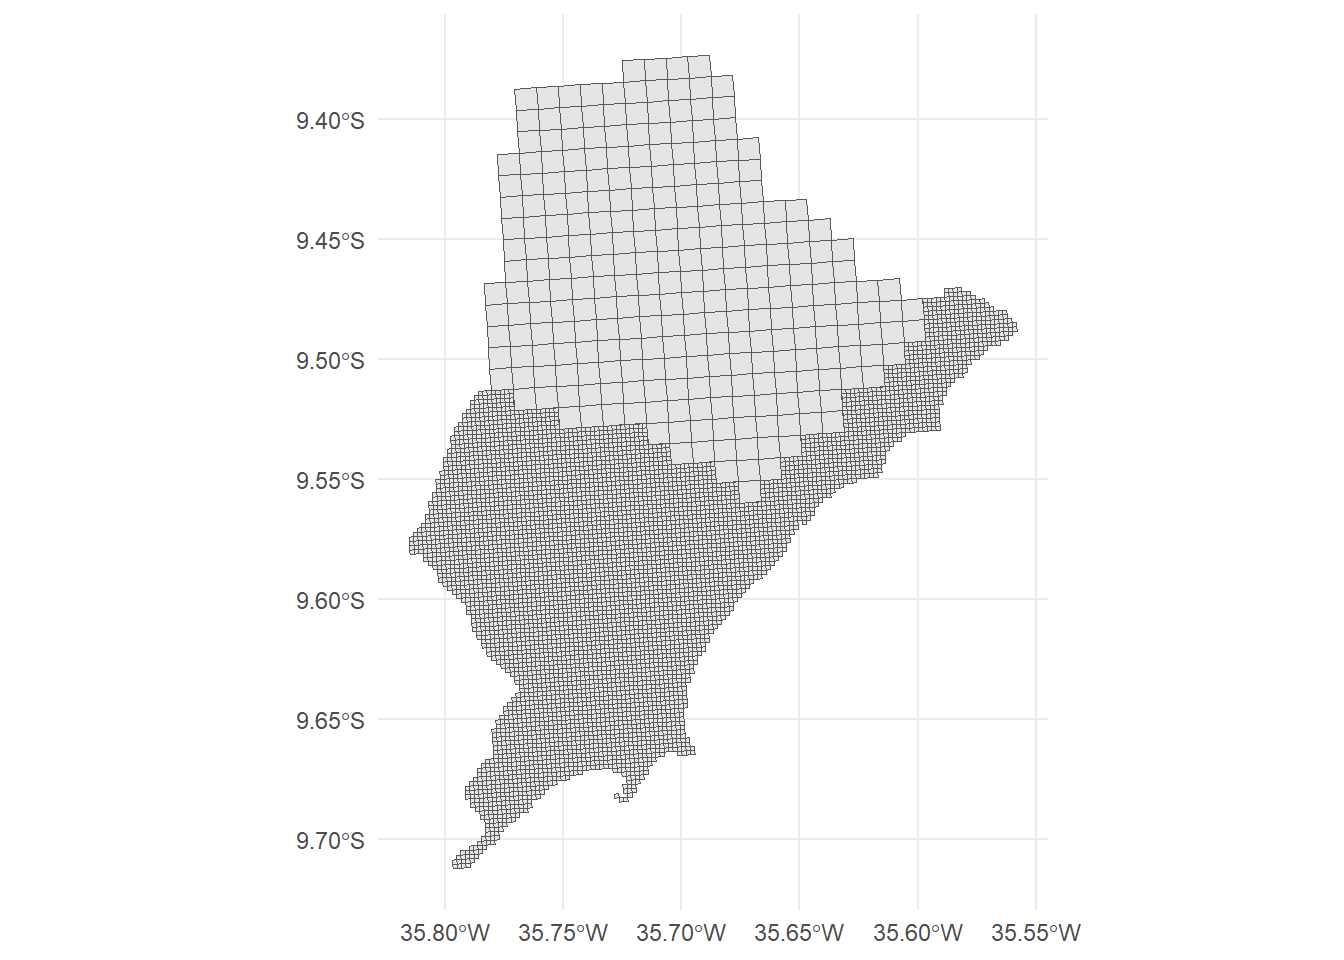
ge_mcz2022 |>
  ggplot() +
  geom_sf() +
  theme_minimal()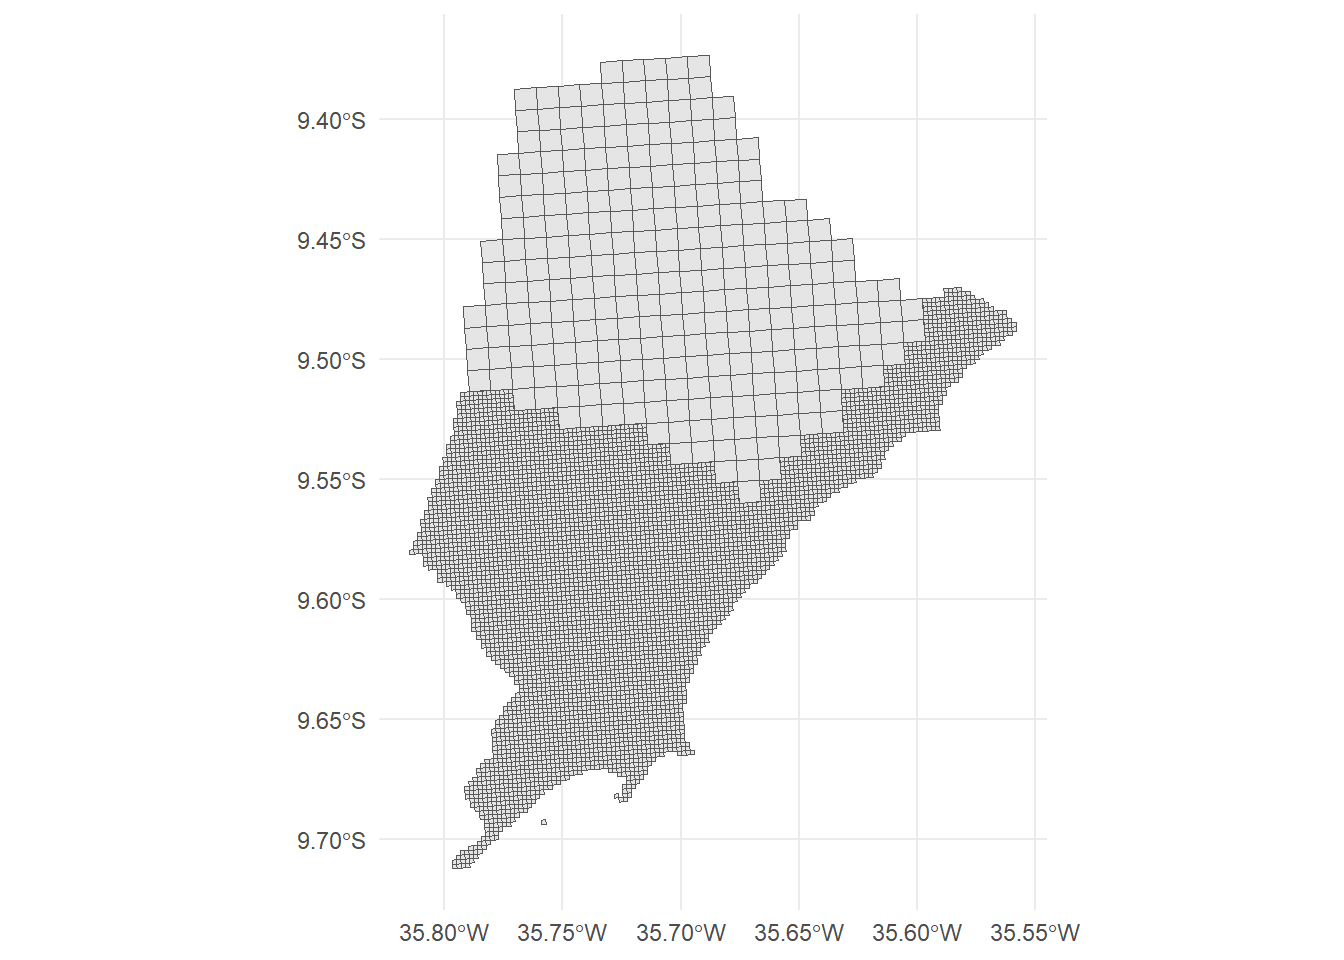
9.5.1 Verificando a correspondência entre as edições
Com os objetos ge_mcz2010 e ge_mcz2022 carregados, é tentador partir direto para um join por id_unico. Antes disso, porém, convém verificar se a correspondência entre as duas edições é de fato completa. A estabilidade do identificador garante que uma célula com o mesmo id_unico representa o mesmo pedaço de território nos dois anos, mas não garante que toda célula de 2022 tenha uma correspondente em 2010.
Há dois motivos para isso. O primeiro é a subdivisão discutida na Seção 9.2, em que uma célula de 1 km de 2010 se torna um conjunto de células de 200 m em 2022 ao ser classificada como urbana. Nesse caso a correspondência existe, mas é de hierarquia diferente, e a chave que a revela é o campo nome_1km, que registra a célula de 1 km à qual cada célula de 200 m pertence. O segundo motivo é a ausência pura e simples de correspondente, seja porque a célula não existia na edição anterior, seja pelas razões de atribuição territorial descritas na nota metodológica ao final desta seção.
Vamos então classificar cada célula de 2022 em três situações, tomando a edição mais recente como ponto de partida. Uma célula tem correspondência direta se o seu id_unico aparece em 2010. Se não aparece, mas é uma célula de 200 m cujo nome_1km consta como célula de 1 km em 2010, então ela é fruto de subdivisão. Restando as duas hipóteses, a célula fica sem correspondência.
ids_2010     <- ge_mcz2010$id_unico
ids_1km_2010 <- ids_2010[str_starts(ids_2010, "1KM")]

niveis <- c("direta", "subdividida", "sem correspondência")

corresp_2022 <- ge_mcz2022 |>
  st_drop_geometry() |>
  mutate(
    situacao = case_when(
      id_unico %in% ids_2010                                     ~ "direta",
      str_starts(id_unico, "200M") & nome_1km %in% ids_1km_2010  ~ "subdividida",
      .default                                                   = "sem correspondência"
    ),
    situacao = factor(situacao, levels = niveis)
  )

corresp_2022 |>
  group_by(situacao, .drop = FALSE) |>
  summarise(celulas = n(), pop = sum(pop_total), .groups = "drop")
# A tibble: 3 × 3
situacao celulas pop
<fct> <int> <dbl>
1 direta 6294 956251
2 subdividida 0 0
3 sem correspondência 49 559O teste mostra que, em Maceió, nenhuma célula resultou de subdivisão. A quase totalidade tem correspondência direta, e sobra um resíduo de algumas dezenas de células sem par, que reúnem pouco mais de meia centena de habitantes. Convém repetir a verificação no sentido inverso, partindo de 2010, para detectar células que existiam naquela edição e não têm correspondente em 2022.
filhas_2022 <- ge_mcz2022 |>
  st_drop_geometry() |>
  filter(str_starts(id_unico, "200M")) |>
  pull(nome_1km)

corresp_2010 <- ge_mcz2010 |>
  st_drop_geometry() |>
  mutate(
    situacao = case_when(
      id_unico %in% ge_mcz2022$id_unico ~ "direta",
      id_unico %in% filhas_2022         ~ "subdividida",
      .default                          = "sem correspondência"
    ),
    situacao = factor(situacao, levels = niveis)
  )

corresp_2010 |>
  group_by(situacao, .drop = FALSE) |>
  summarise(celulas = n(), pop = sum(pop_total), .groups = "drop")
# A tibble: 3 × 3
situacao celulas pop
<fct> <int> <int>
1 direta 6294 920809
2 subdividida 0 0
3 sem correspondência 24 1225O resultado confirma o diagnóstico. Não há subdivisões em nenhum dos dois sentidos e o mesmo conjunto de células se corresponde diretamente nas duas edições, cobrindo mais de 99% da população municipal em cada ano. Para Maceió, portanto, o join direto por id_unico é legítimo, e a etapa de agregação hierárquica que seria necessária em outros municípios pode ser dispensada.
Vale insistir que essa conclusão é um resultado do teste empírico que estamos realizando. Em municípios que se urbanizaram intensamente no período, a categoria “subdividida” é volumosa e ignorá-la produziria buracos nos mapas de variação. O callout ao final da seção detalha esse ponto.
Feita a verificação, o join é simples. Renomeamos as variáveis com sufixos de ano dentro do próprio select(), o que resolve duas coisas de uma vez. A primeira é a colisão de nomes, já que a população total se chama pop_total nas duas edições e o join produziria colunas ambíguas do tipo pop_total.x e pop_total.y. A segunda é a divergência entre dom_ocu e total_dom, apontada na Tabela 9.2.
mcz_ge <- ge_mcz2010 |>
  select(id_unico, pop_2010 = pop_total, dom_2010 = dom_ocu) |>
  left_join(
    ge_mcz2022 |>
      st_drop_geometry() |>
      select(id_unico, pop_2022 = pop_total, dom_2022 = total_dom),
    by = join_by(id_unico)
  ) |>
  mutate(
    varpop = pop_2022 - pop_2010,
    vardom = dom_2022 - dom_2010
  )
NotaTrês cuidados ao comparar edições da Grade
1. A subdivisão existe, ainda que não em Maceió. Aplicando o mesmo teste a todo o estado de Alagoas, encontram-se 463 células de 1 km de 2010 que foram substituídas por células de 200 m em 2022, das quais 372 tinham população, somando cerca de 110 mil habitantes. Elas se concentram em municípios que se urbanizaram no período, com destaque para Arapiraca. Nesses casos, é preciso agregar as células de 2022 de volta ao nível de 1 km antes do join, agrupando por nome_1km e somando população e domicílios.
2. Testar a resolução pelo prefixo do identificador não basta. Uma tentação natural é comparar apenas os conjuntos de células de 1 km das duas edições e supor que as que desapareceram foram subdivididas. Esse atalho mistura fenômenos distintos, porque uma célula pode sumir do conjunto sem ter sido subdividida. A verificação confiável é a que fizemos aqui, que procura as células filhas de 200 m pelo campo nome_1km.
3. O geobr descarta células sem município. Ao preparar os dados, o pacote calcula o centroide de cada célula e o cruza com a malha municipal do ano correspondente. Células cujo centroide cai fora de qualquer polígono municipal, tipicamente sobre lagoas, baías e o mar, ficam sem code_muni e não são devolvidas por nenhuma consulta a município ou estado. No quadrante que cobre Alagoas, isso alcança 12.442 das 145.199 células de 2010. Na área de Maceió são 143 células, quase todas de população zero por estarem sobre a Lagoa Mundaú, embora nove delas somem 226 habitantes. Essa é a razão pela qual a contagem de células obtida pelo geobr é menor do que a dos arquivos originais do FTP, e ajuda a explicar o resíduo sem correspondência dos testes acima.
As células sem correspondência não encontram par no join e recebem NA nas variações, sendo desenhadas em cinza pelo argumento na.value = "gray90" dos mapas a seguir.
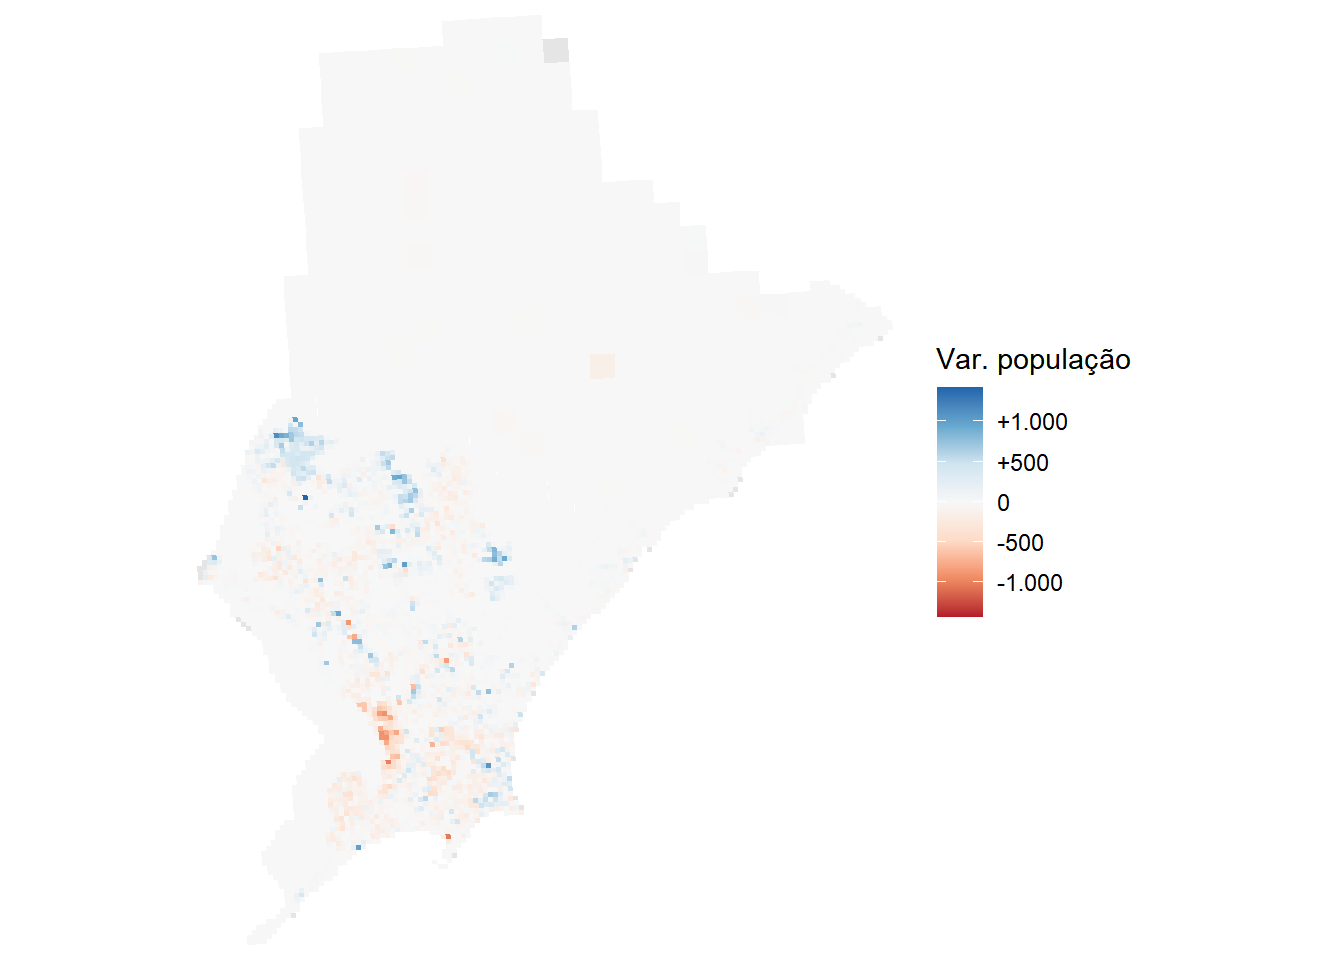
Com mcz_ge pronto, podemos visualizar as variações de população e domicílios ocupados nos mapas interativos da Figura 9.9 e Figura 9.10. Para que a escala de cores destaque tanto as perdas quanto os ganhos de forma simétrica, usamos a paleta divergente "RdBu" com limites iguais em valor absoluto nos dois extremos, calculados a partir de max(abs(...)). Assim, o branco central da paleta corresponde sempre ao zero, vermelho indica redução e azul indica aumento.
lim_pop <- max(abs(mcz_ge$varpop), na.rm = TRUE)

ggplot(mcz_ge) +
  geom_sf(aes(fill = varpop), color = NA) +
  scale_fill_distiller(
    palette   = "RdBu",
    direction = 1,
    limits    = c(-lim_pop, lim_pop),
    name      = "Var. população",
    na.value  = "gray90",
    labels    = scales::label_number(big.mark = ".", decimal.mark = ",",
                                     style_positive = "plus")
  ) +
  coord_sf(expand = FALSE) +
  theme_minimal() +
  theme(
    axis.text  = element_blank(),
    axis.ticks = element_blank(),
    panel.grid = element_blank()
  )
lim_dom <- max(abs(mcz_ge$vardom), na.rm = TRUE)

ggplot(mcz_ge) +
  geom_sf(aes(fill = vardom), color = NA) +
  scale_fill_distiller(
    palette   = "RdBu",
    direction = 1,
    limits    = c(-lim_dom, lim_dom),
    name      = "Var. domicílios",
    na.value  = "gray90",
    labels    = scales::label_number(big.mark = ".", decimal.mark = ",",
                                     style_positive = "plus")
  ) +
  coord_sf(expand = FALSE) +
  theme_minimal() +
  theme(
    axis.text  = element_blank(),
    axis.ticks = element_blank(),
    panel.grid = element_blank()
  )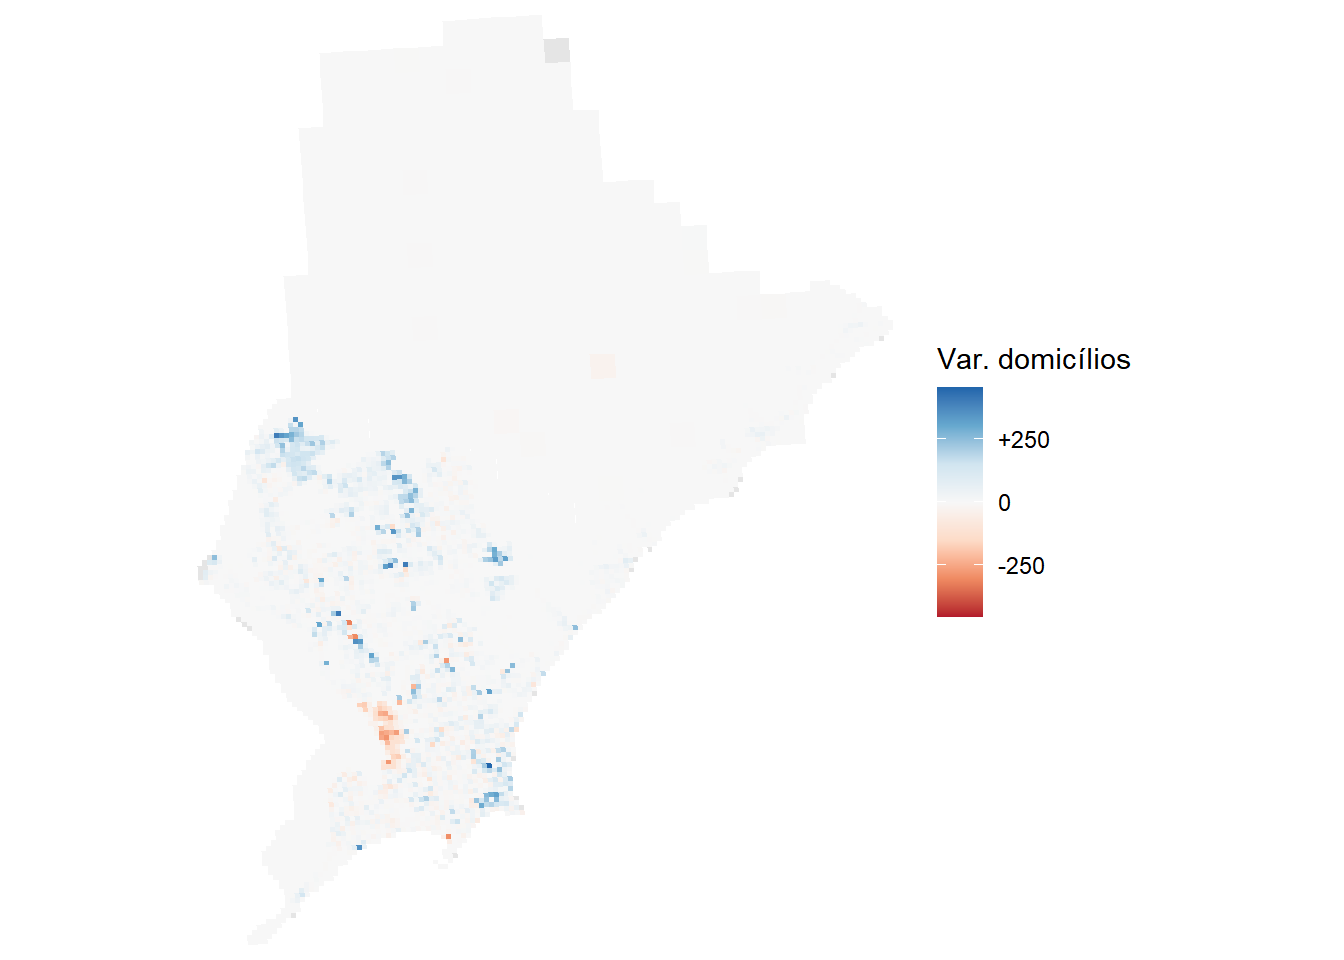
Os mapas evidenciam de forma nítida o impacto dos afundamentos do solo. A mancha vermelha intensa localizada na porção central-oeste da cidade corresponde exatamente aos bairros de Pinheiro, Mutange, Bebedouro e Bom Parto, onde o processo de evacuação compulsória esvaziou centenas de células que em 2010 abrigavam milhares de moradores. Em algumas dessas células, a população foi reduzida a zero entre os dois Censos. O mapa de domicílios ocupados reforça a mesma leitura: a redução no número de residências habitadas acompanha o padrão espacial da perda populacional, sugerindo que os domicílios foram abandonados e não apenas temporariamente desocupados.
Os mapas mostram também um padrão complementar de crescimento em azul em outras regiões da cidade, possivelmente relacionado ao reassentamento de parte das famílias evacuadas em bairros adjacentes ou em novas áreas de expansão urbana ao norte e ao sul. Esse tipo de leitura integrada, conectando as perdas em uma área às possíveis absorções em outras, só é possível porque a Grade cobre todo o município de forma contínua e com resolução suficiente para discriminar bairros vizinhos.
É importante notar que essa análise não seria realizável com os outros produtos do Censo. Com os Agregados por Setor Censitário, a comparação temporal seria inviável porque os identificadores dos setores mudam entre edições. Com os Microdados, a resolução espacial seria insuficiente para isolar os bairros afetados, já que as áreas de ponderação agrupam populações muito maiores. A Grade Estatística, com sua estabilidade identificadora e resolução fina, é o único produto que permite essa leitura direta do impacto territorial.
9.6 Exercícios
Baixe a Grade Estatística de 2022 para Fortaleza (CE) com
read_statistical_grid(). Calcule a densidade populacional de cada célula (habitantes por km²) a partir depop_totale da área obtida comst_area(), e produza um mapa coroplético com escala de cor contínua. Verifique também em quais quadrantes o município se distribui.Utilizando as grades de 2010 e 2022 para Recife (PE), calcule a variação de domicílios ocupados por célula, lembrando que a variável se chama
dom_ocuem 2010 etotal_domem 2022. Produza um mapa com escala de cor divergente. Alguma área da cidade apresenta padrão de variação semelhante ao observado em Maceió?Agregue as células da Grade Estatística de 2022 de Salvador a um recorte espacial de sua escolha (por exemplo, bairros oficiais, zonas de tráfego ou distritos sanitários) somando a população de cada célula que intersecta o recorte. Compare o resultado com a estimativa obtida pela interpolação dasimétrica apresentada no Capítulo 7.
interceptarem setores censitários do tipo urbano no Censo mais recente↩︎
downgrade↩︎
5: mediana das coordenadas de endereços em mesmo logradouro, CEP e localidade; 6: Coordenadas do centroide do Setor Censitário no qual o endereço está contido↩︎
Curiosidade: essa urbanização ocorreu na Ilha dos Frades, que pertence ao município de Salvador↩︎